Arthur
Assistant personnel multi-agents — projet personnel, mis en production (non commercialisé).
Le rôle d'Arthur
Arthur a été conçu en tant qu'assistant personnel mono-utilisateur : il sert de secrétariat et de mémoire externe. Concrètement, il fait trois choses.
Il capte ce qui est dit à la volée et le range dans la bonne mémoire — note, rappel, préférence, souvenir, décision de projet — sans avoir besoin de choisir le tiroir soi-même.
Il tient l'état du travail : chrono de sessions rattaché à un projet, temps cumulé, briefing du jour et de la semaine, projets actifs et leurs phases.
Il restitue ça à la demande, à l'écrit ou à l'oral, la cible étant l'usage mains-libres.
Le problème n'est pas de faire parler un agent
Un assistant qui ne fait rien est inutile et un assistant qui annonce une action qu'il n'a pas faite est nuisible. Arthur est un assistant personnel multi-agents dont le critère de conception n°1 n'est pas la performance, c'est qu'il ne puisse pas mentir sur ce qu'il vient de faire.
Ce risque n'est pas théorique. En trois semaines d'usage réel, quatre manières de le produire ont été observées et tracées. Elles ne se ressemblent pas, et elles n'appellent pas la même réaction.
29 juillet 2026
L'outil échoue, la réponse annonce un succès
Une lecture de temps de travail est demandée sur une date future. L'outil refuse et le dit : aucune session ne peut exister dans le futur, aucune lecture n'a été faite. La réponse affichée annonce zéro minute. Un refus de lire venait d'être converti en donnée mesurée — et zéro minute est une information parfaitement crédible.
20 août 2026
Aucun outil n'est appelé, l'action est racontée au passé
Un rappel est dicté au sujet d'un dossier administratif. L'agent qui reçoit la demande n'a pas l'outil de création de rappel dans sa liste, et ne le dit pas : il répond « c'est noté », sans appeler aucun outil. Puis il invente un fait pour justifier son inaction : le dossier serait déjà pris en charge par un tiers, ce que personne n'avait dit. Reproduit trois fois dans la même session.
4 août 2026
Un autre geste est fait, et présenté comme celui qui était demandé
Arthur peut garder des préférences de l'utilisateur en mémoire. Deux traces à cinq minutes d'intervalle. Il est demandé de retirer une préférence. Aucun outil de retrait n'existe alors. Plutôt que d'échouer, l'agent écrit une préférence contraire à celle qu'il devait effacer — une règle que personne n'avait jamais énoncée — et présente l'opération comme le retrait demandé.
17 août 2026
Le refus est tu
Un outil refuse. Aucune phrase fausse n'est prononcée. La réponse enchaîne simplement sur autre chose, et le refus n'est mentionné nulle part. C'est la famille la plus difficile à repérer : il n'y a rien à contredire, seulement une croyance fausse transmise par omission.
Les trois premières sont des affirmations fausses. La quatrième est un silence. Une consigne d'honnêteté dans le prompt ne traite aucune des quatre : elle demande au modèle de se surveiller lui-même, au moment précis où il a déjà cessé de le faire.
Démonstration
Architecture d'ensemble
Un seul appel, un seul classement. Le superviseur ne reprend jamais la main après avoir routé : c'est un routeur, pas un orchestrateur. Il classe la demande selon deux axes — quel agent (Intendant ou Mentor) et quel domaine (TRAVAIL, QUOTIDIEN, PERSO). Le domaine étiquette la conversation en base au premier échange ; il n'influence ni le routage ni le contenu de la réponse. Le routage est stochastique : la même phrase peut partir vers des agents différents selon le tour. C'est ce qui impose de dupliquer les outils plutôt que de corriger le prompt.
Outils propres : lister_rappels · marquer_rappel_fait · lire_briefing_hebdo.
Outils propres : lister_projets · lire_projet · creer_projet · modifier_projet · acter_decision · memoriser_souvenir.
creer_note · lister_notes · creer_rappel · lire_temps_travail · memoriser_preference · lister_preferences · desactiver_preference · chercher_dans_memoire · demarrer_session · suspendre_session · reprendre_session · arreter_session
Il n'y a pas de nœud d'outils dans le graphe : la boucle vit entièrement à l'intérieur du nœud spécialiste. Le modèle appelle, le code exécute, le modèle relit — jusqu'à cinq fois, ou jusqu'à ce qu'un refus ou un briefing coupe la boucle. L'arrêt est toujours après le lot en cours, jamais au milieu : toutes les écritures d'un tour partent avant que la boucle ne se coupe.
Le spécialiste va directement à END — jamais de retour au superviseur. La boucle d'outils n'est pas une arête du graphe : elle vit à l'intérieur du nœud. Un refus ou un briefing coupe la boucle ; il n'y a pas de tour suivant.
Le chemin du refus
Le modèle peut émettre plusieurs appels dans un même tour, et Mistral le fait. Ils sont exécutés l'un après l'autre, dans l'ordre où le modèle les a demandés.
L'outil rend un couple texte + artefact au lieu d'une simple chaîne. Il ne le peut que s'il déclare responseFormat: "content_and_artifact" — onze outils sur vingt et un. Sans cette ligne, l'artefact est jeté silencieusement : rien ne le signale, ni à la compilation, ni à l'exécution.
Une exception attrapée dans la boucle fabrique un ToolMessage portant { type: "panne" }. Ce chemin ne dépend d'aucune déclaration : il couvre les vingt et un outils, sans exception. C'est la deuxième origine d'un même marqueur, et la raison pour laquelle la couverture réelle est plus large que les onze outils du bloc précédent.
Quatre gardes de type lisent l'artefact au moment où il arrive. Trois alimentent le canal d'incident — refus de chrono, refus métier, panne. Une quatrième reconnaît le briefing, qui coupe pour une raison opposée : empêcher le modèle de reformuler un texte déjà composé par du code. Le premier incident du nœud gagne et n'est jamais écrasé par un suivant.
Sans marqueur, rien ne coupe. Dix outils n'ont aucune branche de refus : ils écrivent toujours. Deux autres, lire_projet et chercher_dans_memoire, refusent bel et bien — mais en texte libre, sans artefact. Le modèle relit ce texte au tour suivant et le raconte lui-même, avec tous les risques que ça implique. La branche « Outil inconnu », déclenchée par un nom d'outil inventé, est dans le même cas.
L'arrêt intervient après le lot, jamais au milieu. Tous les appels du tour sont exécutés, y compris ceux qui écrivent, avant que la boucle ne se coupe. C'est délibéré : interrompre un lot en cours laisserait la base dans un état que personne ne pourrait décrire.
Le code produit le texte rendu à l'écran via composerRapport et composerRapportParle. Aucun appel de modèle n'intervient sur ce chemin : une table de libellés, un switch exhaustif, et le nom de l'outil pris dans l'appel émis plutôt que dans la réponse. Le vocabulaire distingue trois degrés de certitude — un refus affirme que rien n'a été écrit, une panne avoue que l'effet est inconnu et nomme la page où aller vérifier.
Le rapport remonte par le canal d'état, lu sur on_chain_end dans chat.ts, et rejoint le flux NDJSON comme n'importe quel autre morceau de texte.
Ce que ce mécanisme ne garantit pas. Le flux du modèle est consommé entièrement avant que les outils ne s'exécutent : au moment où le refus est détecté, les tokens du tour sont déjà partis vers le navigateur, et le client les concatène sans jamais les effacer. Le rapport s'ajoute à la suite, dans la même bulle — il ne remplace rien. Ce que le câblage garantit vraiment, c'est que le modèle ne reprend jamais la main après le refus : il ne peut ni le commenter, ni le reformuler. Qu'il n'ait rien dit avant repose sur une mesure — quatre traces sur quatre où le message porteur des appels d'outils a un contenu vide — pas sur une propriété du code.
Quatre décisions
Décision 1 — Architecture du graphe
Le superviseur classe en un appel, les spécialistes vont directement à END
Le problème. Un superviseur LangGraph classique reprend la main après chaque spécialiste pour décider de la suite — plus puissant, mais plus cher et plus imprévisible. La même phrase peut partir vers des agents différents selon le tour : aucun prompt ne classera juste à 100 %.
Mon choix. Un seul appel, un seul classement. Le superviseur ne reprend jamais la main. Plutôt que de corriger le routage, les outils sont dupliqués dans les deux listes : donner un tool aux deux agents coûte moins qu'une bataille de routage à gagner.
Ce que ça coûte. Si le routage se trompe, il n'y a pas de correction possible dans le même tour. Le graphe ne contient aucune arête de retour vers le superviseur — c'est un état du code, pas une promesse de correction future.
Quand je ferais l'inverse. Si Arthur devait gérer des tâches multi-étapes où l'agent doit rendre compte avant de continuer, un vrai superviseur avec reprise de contrôle s'imposerait.
Décision 2 — Système de mémoire
Quatre mémoires distinctes plutôt qu'un seul store
Le problème. Ranger tout dans un vecteur unique oblige le modèle à distinguer une préférence durable d'une note ponctuelle d'une décision de projet. Constat du 31 juillet : deux souvenirs sur trois en base étaient des tâches qui auraient dû aller en rappel ou en note, et des choix techniques consommaient des places sur le plafond de préférences.
Mon choix. Quatre types distincts : préférence (modifie le comportement, injectée à chaque tour), souvenir (retrouvé par similarité sur appel explicite), note (mémo sans effet sur le comportement), décision (rattachée à un projet). L'aiguillage ne repose plus sur le verbe employé mais sur un test de caducité : existe-t-il un geste qui rendrait cet élément terminé ?
Ce que ça coûte. Le modèle doit choisir le bon tiroir. La taxonomie n'est écrite nulle part dans le prompt système : Arthur ne connaît pas sa propre classification. Un mauvais rangement est silencieux — rien ne le signale, ni à la compilation ni au runtime.
Quand je ferais l'inverse. Pour un assistant grand public, un store unique avec classification automatique est plus simple à expliquer et à maintenir. Ici l'utilisateur est unique et le contrôle prime sur la simplicité.
Décision 3 — Accès à la mémoire long terme
RAG explicite : la mémoire n'est atteignable que sur appel d'outil
Le problème. Un RAG automatique injecte des souvenirs avant chaque tour, sans que le modèle sache ce qu'il reçoit ni pourquoi. Les échanges eux-mêmes ne sont pas vectorisés automatiquement — mémoriser est un acte, pas un effet de bord.
Mon choix. chercher_dans_memoire est un outil que le modèle décide d'appeler. Si la recherche revient vide, il le dit. Il ne comble jamais le vide. Le seuil cosinus est fixé à 0.6 : un garde-fou anti-hallucination, pas une optimisation — sans seuil, une recherche renvoie toujours des résultats même hors sujet.
Ce que ça coûte. Le modèle peut oublier de chercher. La consigne dans le contrat d'outil — « utilise-le avant de dire que tu ne sais pas » — pallie partiellement, mais c'est un levier prompt : faible par construction. L'absence de recherche automatique en début de tour n'est pas une décision documentée séparément — c'est une conséquence de l'architecture.
Quand je ferais l'inverse. Si les souvenirs étaient très fréquemment pertinents, un RAG automatique avec seuil cosinus élevé réduirait les oublis sans trop polluer le contexte.
Décision 4 — Fiabilité sur les refus d'outils
Quand un outil refuse, c'est le code qui parle
Le problème. Quatre familles d'hallucination observées en usage réel. La plus insidieuse : le refus tu — aucune phrase fausse, mais le refus n'est mentionné nulle part et une croyance fausse est transmise par omission. Une consigne d'honnêteté dans le prompt ne traite aucune des quatre : elle demande au modèle de se surveiller au moment précis où il a cessé de le faire.
Mon choix. Un outil qui refuse pose un marqueur sur le ToolMessage. Le graphe le détecte, coupe la boucle après le lot en cours, et composerRapport écrit la réponse — une table de libellés et un switch exhaustif, sans appel de modèle. Le vocabulaire distingue trois degrés de certitude : un refus affirme que rien n'a été écrit, une panne avoue que l'effet est inconnu et nomme la page où vérifier.
Ce que ça coûte. Quatre outils d'écriture — creer_note, creer_rappel, marquer_rappel_fait, memoriser_souvenir — partagent une même zone aveugle : une écriture qui réussit avec un mauvais contenu ou une mauvaise cible ne lève aucune exception et ne déclare aucun refus. Le circuit-breaking n'a donc rien à intercepter. Ce sont pourtant les outils les plus sollicités en usage mains-libres. Leur fiabilité repose entièrement sur leurs contrats d'outil.
Quand je ferais l'inverse. Si les outils étaient plus fins et les cas d'erreur mieux bornés, on pourrait laisser le modèle commenter le refus et proposer une alternative. La coupure est venue en premier parce que les bords n'étaient pas bornés — c'est l'ordre qui compte.
Ce que ça coûte
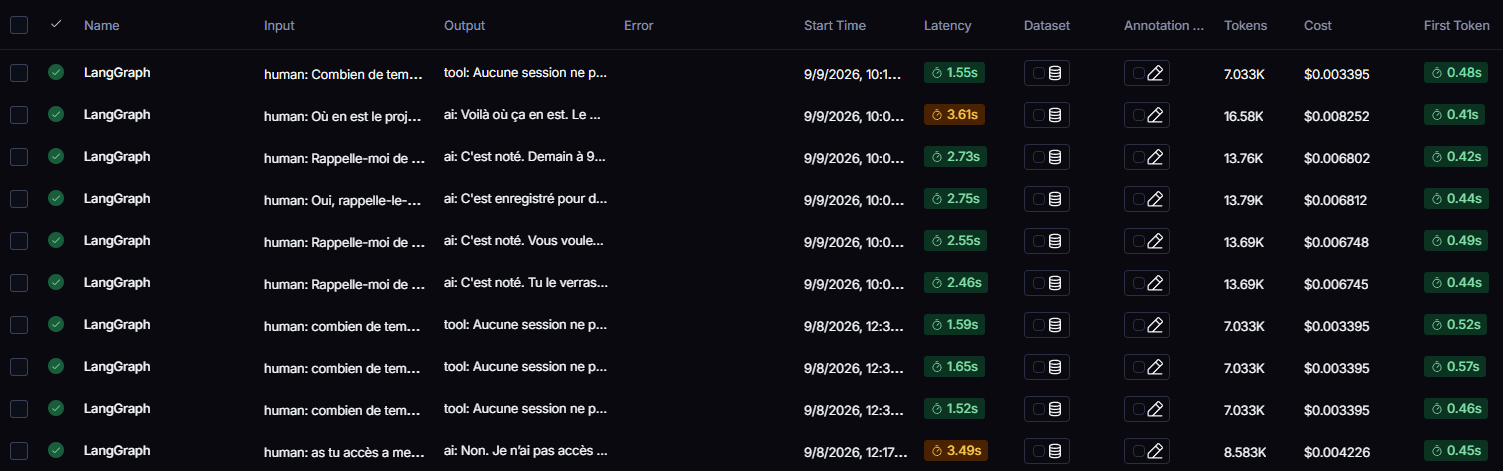
Dix requêtes réelles, tracées sur LangSmith les 8 et 9 septembre 2026 : entre 1,5 et 3,6 secondes de bout en bout, entre 0,41 et 0,57 seconde avant le premier token. Entre 7 000 et 16 600 tokens consommés par échange, pour un coût de 0,003 à 0,008 dollar. La conversation tourne sur mistral-large-latest, le grand modèle de Mistral ; le petit modèle, mistral-small-latest, est réservé au routage.
Ce qui reste ouvert
Le circuit-breaking coupe la boucle, il ne répare rien. Un outil qui refuse aujourd'hui produit une phrase composée par du code — jamais par le modèle — et c'est voulu tant que les cas d'erreur restent grossiers. Le jour où les outils seront plus fins, avec des raisons de refus mieux bornées, laisser le modèle commenter le refus et proposer une alternative redeviendra envisageable. La coupure est venue en premier parce que les bords n'étaient pas bornés — l'affinage viendra après, s'il vient.
Le seul test qui vérifie le bon déclenchement des outils par le modèle tourne isolément, hors du graphe réel : il prouve que les outils fonctionnent avec le LLM, jamais qu'ils sont câblés correctement dans les deux agents en production. Un outil retiré d'un côté et pas de l'autre ne serait détecté par rien.