Arthur
Persönlicher Multi-Agenten-Assistent — persönliches Projekt, in Produktion, nicht kommerzialisiert.
Was Arthur macht
Arthur wurde als persönlicher Assistent für einen einzelnen Nutzer konzipiert: als Sekretariat und externes Gedächtnis. Konkret macht er drei Dinge.
Er erfasst, was spontan gesagt wird, und legt es in das richtige Gedächtnis ab — Notiz, Erinnerung, Präferenz, Andenken, Projektentscheidung — ohne selbst die Schublade auswählen zu müssen.
Er verfolgt den Arbeitsstand: Sitzungstimer je Projekt, kumulierte Zeit, Tages- und Wochenbriefing, aktive Projekte und ihre Phasen.
Er gibt das auf Anfrage wieder, schriftlich oder mündlich, mit dem Ziel der freihändigen Nutzung.
Das Problem ist nicht, einen Agenten zum Sprechen zu bringen
Ein Assistent, der nichts tut, ist nutzlos, und einer, der eine Aktion ankündigt, die er nicht ausgeführt hat, ist schädlich. Arthur ist ein persönlicher Multi-Agenten-Assistent, dessen Designkriterium Nr. 1 nicht Leistung ist — sondern dass er nicht über das lügen kann, was er gerade getan hat.
Dieses Risiko ist nicht theoretisch. In drei Wochen realen Einsatzes wurden vier Wege beobachtet und dokumentiert, es zu erzeugen. Sie ähneln sich nicht, und sie erfordern nicht dieselbe Reaktion.
29. Juli 2026
Das Tool schlägt fehl, die Antwort verkündet Erfolg
Eine Arbeitszeitabfrage wird für ein zukünftiges Datum gestellt. Das Tool verweigert und sagt es: In der Zukunft kann es keine Sitzung geben, es wurde nichts gelesen. Die angezeigte Antwort meldet null Minuten. Eine Leseverweigerung wurde in einen gemessenen Wert umgewandelt — und null Minuten ist eine vollkommen glaubwürdige Information.
20. August 2026
Kein Tool wird aufgerufen, die Aktion wird in der Vergangenheit erzählt
Eine Erinnerung zu einem Verwaltungsvorgang wird diktiert. Der Agent, der die Anfrage erhält, hat das Erinnerungs-Tool nicht in seiner Liste — und sagt es nicht: Er antwortet „ist notiert“, ohne irgendein Tool aufzurufen. Dann erfindet er eine Tatsache, um seine Untätigkeit zu rechtfertigen: Der Vorgang werde bereits von einem Dritten übernommen — das hatte niemand gesagt. Dreimal in derselben Sitzung reproduziert.
4. August 2026
Eine andere Aktion wird ausgeführt und als die gewünschte dargestellt
Arthur kann Nutzerpräferenzen im Gedächtnis speichern. Zwei Traces im Abstand von fünf Minuten. Es wird gebeten, eine Präferenz zu entfernen. Kein Entfernungs-Tool existiert zu diesem Zeitpunkt. Anstatt zu scheitern, schreibt der Agent eine Präferenz, die der zu löschenden widerspricht — eine Regel, die niemand je formuliert hatte — und stellt den Vorgang als die gewünschte Entfernung dar.
17. August 2026
Die Verweigerung wird verschwiegen
Ein Tool verweigert. Es wird keine falsche Aussage gemacht. Die Antwort geht einfach zu etwas anderem über, und die Verweigerung wird nirgends erwähnt. Das ist die schwierigste Familie: Es gibt nichts zu widerlegen, nur einen falschen Glauben, der durch Auslassung übermittelt wird.
Die ersten drei sind falsche Aussagen. Die vierte ist Schweigen. Eine Ehrlichkeitsanweisung im Prompt behandelt keine der vier: Sie fordert das Modell auf, sich selbst zu überwachen, genau in dem Moment, in dem es damit aufgehört hat.
Demo
Gesamtarchitektur
Ein Aufruf, eine Klassifizierung. Der Supervisor übernimmt nach dem Routing nie wieder das Wort: Er ist ein Router, kein Orchestrator. Er klassifiziert die Anfrage nach zwei Achsen — welcher Agent (Intendant oder Mentor) und welche Domäne (ARBEIT, ALLTAG, PERSÖNLICH). Die Domäne beschriftet die Konversation beim ersten Austausch in der Datenbank; sie beeinflusst weder das Routing noch den Antwortinhalt. Das Routing ist stochastisch: Derselbe Satz kann je nach Turn zu verschiedenen Agenten gehen. Das macht es erforderlich, Tools zu duplizieren statt den Prompt zu korrigieren.
Eigene Tools: lister_rappels · marquer_rappel_fait · lire_briefing_hebdo.
Eigene Tools: lister_projets · lire_projet · creer_projet · modifier_projet · acter_decision · memoriser_souvenir.
creer_note · lister_notes · creer_rappel · lire_temps_travail · memoriser_preference · lister_preferences · desactiver_preference · chercher_dans_memoire · demarrer_session · suspendre_session · reprendre_session · arreter_session
Es gibt keinen Tool-Knoten im Graphen: Die Schleife lebt vollständig innerhalb des Spezialistenknoten. Das Modell ruft auf, der Code führt aus, das Modell liest erneut — bis zu fünfmal, oder bis ein Verweigerung oder ein Briefing die Schleife unterbricht. Der Stopp kommt immer nach dem aktuellen Stapel, nie mittendrin: Alle Schreibvorgänge eines Turns werden abgeschlossen, bevor die Schleife abbricht.
Der Spezialist geht direkt zu END — nie zurück zum Supervisor. Die Tool-Schleife ist keine Kante im Graphen: Sie lebt innerhalb des Knotens. Eine Verweigerung oder ein Briefing unterbricht die Schleife; es gibt keinen nächsten Turn.
Der Verweigerungspfad
Das Modell kann mehrere Aufrufe in einem Turn ausgeben, und Mistral tut es. Sie werden nacheinander ausgeführt, in der Reihenfolge, in der das Modell sie angefordert hat.
Das Tool gibt ein Text-+Artefakt-Paar zurück statt einer einfachen Zeichenkette. Es kann dies nur, wenn es responseFormat: "content_and_artifact" deklariert — elf Tools von einundzwanzig. Ohne diese Zeile wird das Artefakt stillschweigend verworfen: nichts zeigt es an, weder zur Compile-Zeit noch zur Laufzeit.
Eine in der Schleife gefangene Ausnahme erstellt eine ToolMessage mit { type: "panne" }. Dieser Pfad hängt von keiner Deklaration ab: Er deckt alle einundzwanzig Tools ab, ohne Ausnahme. Es ist der zweite Ursprung desselben Markers und der Grund, warum die tatsächliche Abdeckung breiter ist als die elf Tools des vorherigen Blocks.
Vier Typwächter lesen das Artefakt, wenn es ankommt. Drei speisen den Incident-Kanal — Chrono-Verweigerung, Geschäftsverweigerung, Panne. Ein vierter erkennt das Briefing, das aus dem entgegengesetzten Grund unterbricht: das Modell daran zu hindern, bereits vom Code zusammengestellten Text umzuformulieren. Der erste Incident im Knoten gewinnt und wird nie von einem späteren überschrieben.
Ohne Marker bricht nichts ab. Zehn Tools haben keinen Verweigerungszweig: Sie schreiben immer. Zwei andere, lire_projet und chercher_dans_memoire, verweigern zwar — aber in Freitext, ohne Artefakt. Das Modell liest diesen Text im nächsten Turn erneut und erzählt ihn selbst, mit allen damit verbundenen Risiken. Der 'Unbekanntes Tool'-Zweig, ausgelöst durch einen erfundenen Tool-Namen, ist im gleichen Fall.
Der Stopp kommt nach dem Stapel, nie mittendrin. Alle Aufrufe des Turns werden ausgeführt, auch die schreibenden, bevor die Schleife abbricht. Das ist gewollt: Ein Stapel mittendrin zu unterbrechen würde die Datenbank in einem Zustand hinterlassen, den niemand beschreiben könnte.
Der Code erzeugt den auf dem Bildschirm angezeigten Text über composerRapport und composerRapportParle. Kein Modellaufruf findet auf diesem Pfad statt: eine Bezeichnungstabelle, ein exhaustiver switch und der Tool-Name aus dem ausgegebenen Aufruf statt aus der Antwort. Das Vokabular unterscheidet drei Gewissheitsgrade — eine Verweigerung bestätigt, dass nichts geschrieben wurde, eine Panne gibt zu, dass der Effekt unbekannt ist, und nennt die Seite zum Nachprüfen.
Der Bericht steigt über den Zustandskanal auf, wird auf on_chain_end in chat.tsgelesen und tritt dem NDJSON-Stream wie jedes andere Textstück bei.
Was dieser Mechanismus nicht garantiert. Der Stream des Modells wird vollständig verarbeitet, bevor die Tools ausgeführt werden: Wenn die Verweigerung erkannt wird, sind die Tokens des Turns bereits beim Browser angekommen, und der Client hängt sie an, ohne sie je zu löschen. Der Bericht wird in derselben Blase angehängt — er ersetzt nichts. Was die Verkabelung wirklich garantiert, ist, dass das Modell nach einer Verweigerung nie wieder das Wort erhält: Es kann sie weder kommentieren noch umformulieren. Dass es vorher nichts gesagt hat, beruht auf einer Messung — vier Traces von vier, bei denen die Nachricht mit Tool-Calls leeren Inhalt hatte — nicht auf einer Code-Eigenschaft.
Vier Entscheidungen
Entscheidung 1 — Graph-Architektur
Der Supervisor klassifiziert in einem Aufruf, Spezialisten gehen direkt zu END
Das Problem. Ein Standard-LangGraph-Supervisor übernimmt nach jedem Spezialisten wieder das Wort, um zu entscheiden, was als nächstes kommt — mächtiger, aber teurer und unvorhersehbarer. Derselbe Satz kann je nach Turn zu verschiedenen Agenten gehen: Kein Prompt wird zu 100 % korrekt routen.
Meine Entscheidung. Ein Aufruf, eine Klassifizierung. Der Supervisor übernimmt nie wieder das Wort. Statt das Routing zu korrigieren, werden Tools in beiden Listen dupliziert: Ein Tool beiden Agenten zu geben kostet weniger als eine Routing-Fehlerkorrektur.
Der Preis. Wenn das Routing einen Fehler macht, gibt es keine Korrekturmöglichkeit im selben Turn. Der Graph enthält keine Rückkehrkante zum Supervisor — das ist ein Zustand des Codes, keine Versprechen einer zukünftigen Korrektur.
Wann ich es umgekehrt machen würde. Wenn Arthur mehrstufige Aufgaben verwalten müsste, bei denen der Agent Bericht erstatten muss, bevor er weitermacht, wäre ein echter Supervisor mit Kontrollübergabe notwendig.
Entscheidung 2 — Gedächtnissystem
Vier verschiedene Gedächtnistypen statt eines einzigen Speichers
Das Problem. Alles in einem einzigen Vektor zu speichern zwingt das Modell, eine dauerhafte Präferenz von einer einmaligen Notiz von einer Projektentscheidung zu unterscheiden. Beobachtung vom 31. Juli: Zwei von drei Erinnerungen in der Datenbank waren Aufgaben, die in Erinnerungen oder Notizen gehört hätten, und technische Entscheidungen verbrauchten Plätze im Präferenzlimit.
Meine Entscheidung. Vier verschiedene Typen: Präferenz (ändert das Verhalten, wird bei jedem Turn injiziert), Erinnerung (durch Ähnlichkeit auf expliziten Aufruf abrufbar), Notiz (Memo ohne Auswirkung auf das Verhalten), Entscheidung (an ein Projekt gebunden). Das Routing basiert nicht mehr auf dem verwendeten Verb, sondern auf einem Verfallbarkeitstest: Gibt es eine Handlung in der Welt, die dieses Element abschließen würde?
Der Preis. Das Modell muss die richtige Schublade wählen. Die Taxonomie ist nirgendwo im System-Prompt geschrieben: Arthur kennt seine eigene Klassifikation nicht. Eine falsche Ablage ist still — nichts signalisiert sie, weder zur Compile-Zeit noch zur Laufzeit.
Wann ich es umgekehrt machen würde. Für einen allgemeinen Assistenten ist ein einziger Speicher mit automatischer Klassifikation einfacher zu erklären und zu warten. Hier ist der Nutzer einzigartig und die Kontrolle hat Vorrang vor der Einfachheit.
Entscheidung 3 — Zugriff auf das Langzeitgedächtnis
Explizites RAG: Gedächtnis ist nur über Tool-Aufruf erreichbar
Das Problem. Automatisches RAG injiziert Erinnerungen vor jedem Turn, ohne dass das Modell weiß, was es erhält oder warum. Gespräche selbst werden nicht automatisch vektorisiert — Memorieren ist ein Akt, kein Nebeneffekt.
Meine Entscheidung. chercher_dans_memoire ist ein Tool, das das Modell selbst aufruft. Wenn die Suche leer zurückkommt, sagt es das. Es füllt die Lücke nie. Der Cosinus-Schwellenwert ist auf 0,6 gesetzt: eine Anti-Halluzinations-Schutzmaßnahme, keine Optimierung — ohne Schwellenwert liefert eine Suche immer Ergebnisse, auch wenn sie nicht relevant sind.
Der Preis. Das Modell kann vergessen zu suchen. Die Anweisung im Tool-Vertrag — 'benutze es, bevor du sagst, dass du es nicht weißt' — kompensiert das teilweise, aber es ist ein Prompt-Hebel: von Natur aus schwach. Die fehlende automatische Suche zu Beginn jedes Turns ist keine separat dokumentierte Entscheidung — sie ist eine Konsequenz der Architektur.
Wann ich es umgekehrt machen würde. Wenn Erinnerungen sehr häufig relevant wären, würde automatisches RAG mit einem hohen Cosinus-Schwellenwert verpasste Suchen reduzieren, ohne den Kontext zu sehr zu verschmutzen.
Entscheidung 4 — Zuverlässigkeit bei Tool-Verweigerungen
Wenn ein Tool verweigert, spricht der Code
Das Problem. Vier Halluzinationsfamilien in realem Einsatz beobachtet. Die heimtückischste: die verschwiegene Verweigerung — keine falsche Aussage, aber die Verweigerung wird nirgends erwähnt und ein falscher Glaube wird durch Auslassung übermittelt. Eine Ehrlichkeitsanweisung im Prompt behandelt keine der vier: Sie fordert das Modell auf, sich selbst zu überwachen, genau in dem Moment, in dem es damit aufgehört hat.
Meine Entscheidung. Ein Tool, das verweigert, setzt einen Marker auf dem ToolMessage. Der Graph erkennt ihn, bricht die Schleife nach dem aktuellen Stapel ab, und composerRapport schreibt die Antwort — eine Bezeichnungstabelle und ein exhaustiver switch, ohne Modellaufruf. Das Vokabular unterscheidet drei Gewissheitsgrade: Eine Verweigerung bestätigt, dass nichts geschrieben wurde, eine Panne gibt zu, dass der Effekt unbekannt ist, und nennt die Seite zum Nachprüfen.
Der Preis. Vier Schreib-Tools — creer_note, creer_rappel, marquer_rappel_fait, memoriser_souvenir — teilen denselben blinden Fleck: Ein Schreibvorgang, der mit falschem Inhalt oder falschem Ziel gelingt, löst keine Ausnahme aus und meldet keine Verweigerung. Circuit-Breaking hat also nichts abzufangen. Diese sind jedoch die am häufigsten verwendeten Tools im Freihand-Modus. Ihre Zuverlässigkeit hängt vollständig von ihren Tool-Verträgen ab.
Wann ich es umgekehrt machen würde. Wenn die Tools präziser wären und Fehlerfälle besser eingegrenzt wären, könnte man das Modell die Verweigerung kommentieren und eine Alternative vorschlagen lassen. Der Schnitt kam zuerst, weil die Ränder nicht eingegrenzt waren — das ist die Reihenfolge, die zählt.
Was es kostet
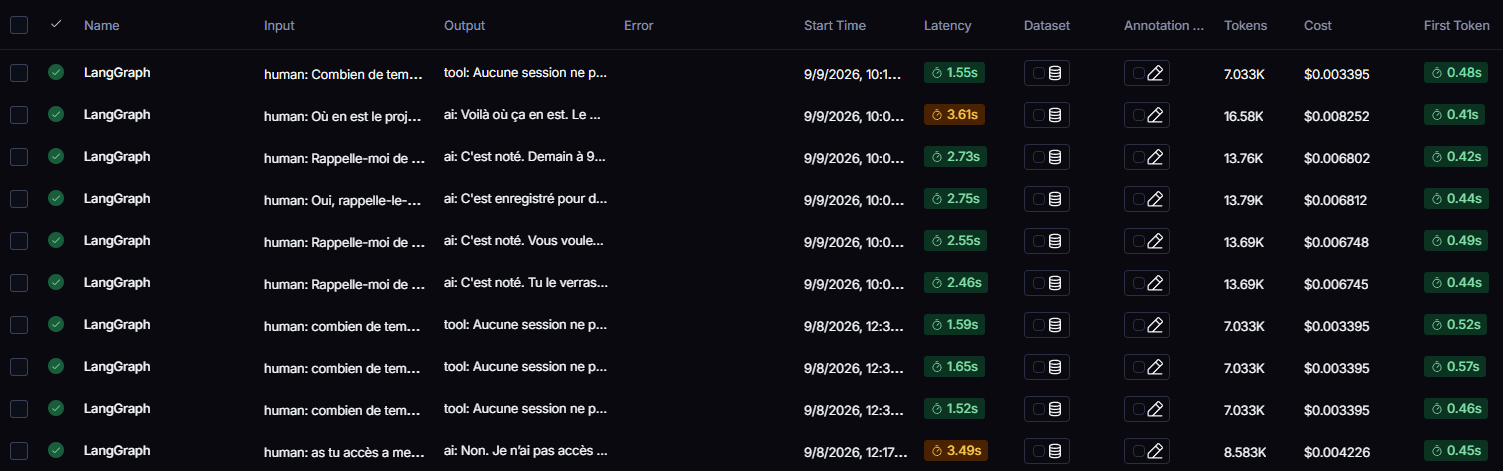
Zehn reale Anfragen, am 8. und 9. September 2026 mit LangSmith nachverfolgt: zwischen 1,5 und 3,6 Sekunden von Anfang bis Ende, zwischen 0,41 und 0,57 Sekunden bis zum ersten Token. Zwischen 7.000 und 16.600 Tokens pro Austausch, für Kosten von 0,003 bis 0,008 Dollar. Das Gespräch läuft auf mistral-large-latest, dem großen Modell von Mistral; das kleine Modell, mistral-small-latest, ist dem Routing vorbehalten.
Was offen bleibt
Circuit-Breaking unterbricht die Schleife, es repariert nichts. Ein Tool, das heute verweigert, erzeugt einen vom Code verfassten Satz — nie vom Modell — und das ist beabsichtigt, solange die Fehlerfälle grob bleiben. Sobald die Tools feiner werden, mit besser eingegrenzten Verweigerungsgründen, wird es wieder sinnvoll, das Modell die Verweigerung kommentieren und eine Alternative vorschlagen zu lassen. Der Schnitt kam zuerst, weil die Ränder nicht eingegrenzt waren — die Verfeinerung kommt danach, falls sie kommt.
Der einzige Test, der die korrekte Auslösung der Tools durch das Modell prüft, läuft isoliert, außerhalb des echten Graphen: Er belegt, dass die Tools mit dem LLM funktionieren, nie, dass sie korrekt in die beiden Produktions-Agenten eingebunden sind. Ein Tool, das auf einer Seite entfernt wird und auf der anderen nicht, würde von nichts erkannt.